
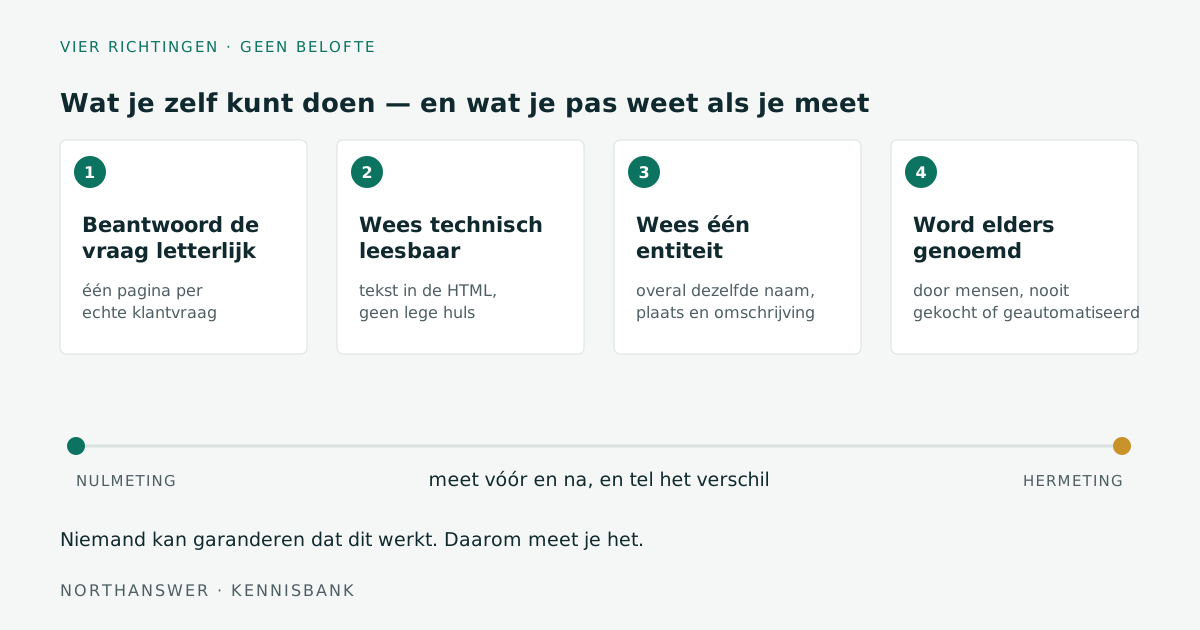
Hoe beantwoord je de klantvraag letterlijk?
De meeste websites beschrijven wat een bedrijf aanbiedt. Een klant stelt iets anders: een hele vraag, in eigen woorden, met een plaats en een situatie erin. „Wie kan mijn loonadministratie doen voor een café in Leiden?” is een andere tekst dan „Onze diensten”. Maak per belangrijke klantvraag één pagina die precies díé vraag beantwoordt: de vraag als kop, het antwoord in de eerste alinea, en daarna de details — voor wie het is, waar je werkt, wat het kost of waarom je dat niet op de site zet.
Waarom dit zou kunnen helpen: een taalmodel stelt zijn antwoord samen uit tekst die het kent, en tekst die de vraag letterlijk beantwoordt, ligt dichter bij het antwoord dan een brochurezin. Wat je er niet van mag verwachten: dat je pagina meteen meetelt. Anthropic definieert in zijn modeloverzicht de „reliable knowledge cutoff” als „the date through which the model's knowledge is most extensive and reliable”. Wat je vandaag publiceert, kent een model alleen als het live op het web zoekt — pas bij een volgende training kan het in het geheugen terechtkomen, en of dat gebeurt weet niemand.
Waarom moet je pagina zonder JavaScript leesbaar zijn?
Veel moderne sites bouwen hun tekst pas op in de browser. Een lezer ziet dan een keurige pagina, maar een programma dat de pagina ophaalt krijgt een lege huls. Zet de belangrijkste tekst daarom in de HTML zelf: één duidelijke titel, koppen die vragen zijn, en het antwoord als gewone tekst. Voeg gestructureerde gegevens toe waar ze kloppen — een organisatie, een dienst, een veelgestelde vraag die ook echt op de pagina staat — en verzin er nooit iets bij dat de bezoeker niet ziet.
Waarom dit zou kunnen helpen: wat niet gelezen kan worden, kan ook niet worden overgenomen. Wat je er niet van mag verwachten: dat leesbaarheid een reden is om genoemd te worden. Het is een voorwaarde, geen argument. Een perfect leesbare pagina over een dienst die nergens anders beschreven staat, blijft een stille pagina.
Wie ben je volgens de rest van het internet?
Zoek jezelf op zoals een vreemde dat zou doen: je handelsnaam, je bedrijfsnaam, je oude naam, je vestigingsplaats. Kom je jezelf tegen met drie schrijfwijzen, twee adressen en vier omschrijvingen, dan is er voor een model niet één bedrijf maar een wolk van halve bedrijven. Kies één naam, één adres, één KvK-nummer en één omschrijving van wat je doet, en zet die overal gelijk: je eigen site, je vermeldingen, je profielen, je facturen, je e-mailhandtekening.
Waarom dit zou kunnen helpen: eenduidige tekst is makkelijker samen te vatten dan tegenstrijdige tekst, en dat is precies wat een model doet. Wat je er niet van mag verwachten: dat opruimen een effect heeft dat je binnen een week ziet. Bestaande tekst op andermans site verandert niet omdat jij je eigen site aanpast.
Hoe word je elders genoemd, zonder trucs?
Het lastigste deel, en het enige dat je niet in je eentje kunt regelen: vermeld worden op plekken waar assistenten lezen. Denk aan een vakblad dat je citeert, een brancheorganisatie met een ledenlijst, een klant die in een interview vertelt wat je gedaan hebt, een lokale nieuwssite, een gids die echt gebruikt wordt. Dat is mensenwerk: je vraagt het, of je verdient het met iets wat de moeite van het schrijven waard is. Wij doen dit niet automatisch, wij kopen geen links, en wij plaatsen niets namens jou. Een netwerk van gekochte vermeldingen is geen vindbaarheid maar een risico.
Waarom dit zou kunnen helpen: het is de enige richting die tekst toevoegt die niet van jezelf komt — en dat is precies het materiaal waaruit een model put. Waarom een concurrent daardoor eerder genoemd kan worden zonder beter te zijn, staat in „Waarom noemt ChatGPT mijn concurrent wel?”. Wat je er niet van mag verwachten: een aantal vermeldingen waarna het „werkt”. Die drempel bestaat niet, en wie hem noemt heeft hem verzonnen.
Wat mag je hiervan verwachten?
| Richting | Waarom het zou kunnen helpen | Wat je er niet van mag verwachten |
|---|---|---|
| De vraag letterlijk beantwoorden | Tekst die de klantvraag in klanttaal beantwoordt ligt dichter bij een antwoord dan een brochurezin | Direct effect: nieuwe tekst bereikt het geheugen van een model pas bij een volgende training, als het al gebeurt |
| Technisch leesbaar zijn | Wat niet gelezen kan worden, kan niet worden overgenomen | Dat leesbaarheid zelf een reden is om genoemd te worden; het is een voorwaarde |
| Eén herkenbare entiteit zijn | Eenduidige tekst is makkelijker samen te vatten dan tegenstrijdige tekst | Dat andermans oude vermeldingen meeveranderen als jij je eigen site opruimt |
| Elders genoemd worden door mensen | Het voegt tekst toe die niet van jezelf komt — het materiaal waaruit een model put | Een drempel waarna het „werkt”; die bestaat niet, en gekochte vermeldingen zijn een risico |
Er is geen vijfde richting die dit zeker maakt. Volgens de API-documentatie van Anthropic zijn de resultaten „even with temperature of 0.0 … not fully deterministic”: hetzelfde model kan op dezelfde vraag twee keer iets anders antwoorden. Eén beter antwoord na een aanpassing bewijst dus niets, en één slechter antwoord ook niet. Alleen een herhaalde meting vóór en na laat een verschil zien dat groter is dan de ruis.
Hoe die meting precies in elkaar zit — welke vijf aanbieders, waarom vijf herhalingen, en hoe je elk cijfer terugzoekt met een bewijs-ID — staat op onze meetmethode.