
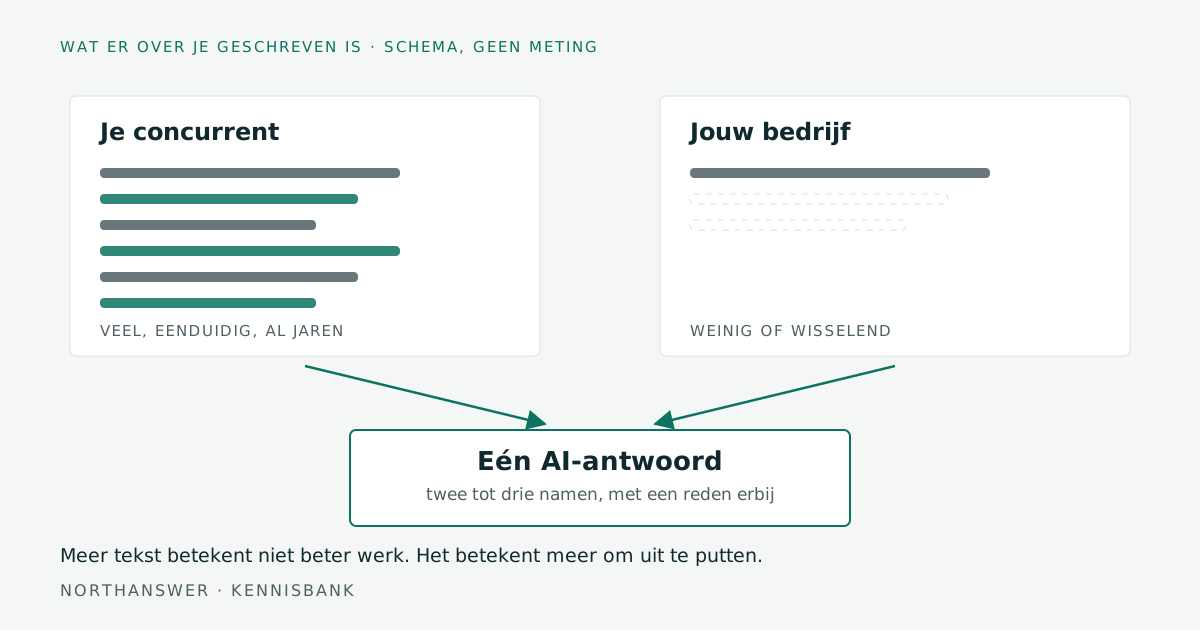
Waarom noemt een AI-assistent überhaupt namen?
Een AI-assistent zoekt bedrijven niet op in een register en kiest daar niet de beste uit. Hij is getraind op enorme hoeveelheden tekst en stelt zijn antwoord woord voor woord samen op basis van wat daarin het meest waarschijnlijk volgt. Namen die vaak, consistent en in duidelijke context in die tekst voorkomen, hebben meer kans om terug te komen dan namen die zelden of wisselend beschreven staan. Je eigen website telt daarin mee, maar het is één stem tussen vele: een branchegids, een nieuwsbericht, een forumdraadje of een vergelijkingspagina wegen mee zonder dat jij daar iets over te zeggen hebt.
Er zit ook een grens aan wat een model weet. Anthropic definieert in zijn modeloverzicht de „reliable knowledge cutoff” als „the date through which the model's knowledge is most extensive and reliable”. Wat na die datum verscheen, kent het model alleen als het live op het web zoekt. Een concurrent die al jaren op dezelfde manier beschreven wordt, heeft daardoor een voorsprong die niets met kwaliteit te maken heeft: er is simpelweg meer, ouder en vaker overgenomen materiaal over hem.
Is dat antwoord een ranglijst?
Nee. Een zoekmachine verzamelt pagina's en zet die op volgorde. Een AI-assistent doet iets anders: hij schrijft één samenhangend antwoord en noemt daarin de namen die in zijn reconstructie passen. Er is geen positie één en geen positie zeven. Wie erin staat, staat erin; wie er niet in staat, ontbreekt — en de volgende keer kan de samenstelling anders zijn. Volgens de API-documentatie van Anthropic zijn de resultaten „even with temperature of 0.0 … not fully deterministic”. Eén antwoord is dus een momentopname, geen uitslag.
Waarom kan je concurrent genoemd worden zonder dat hij beter is?
Er zijn redenen die niets met de kwaliteit van zijn dienstverlening te maken hebben. Vier veelvoorkomende — dit is redenering, geen meting:
- Er wordt méér over hem geschreven. Meer vermeldingen op meer plekken betekent meer tekst waaruit een model kan putten.
- Zijn dienst staat duidelijker beschreven. „Wij ontzorgen ondernemers” is voor een model geen dienst; „loonadministratie voor horecabedrijven in Zuid-Holland” wel.
- Zijn pagina's zijn ouder en vaker geciteerd. Materiaal dat lang online staat en door anderen wordt overgenomen, komt vaker terug in de tekst waarop een model getraind is.
- Hij is één herkenbare entiteit. Overal dezelfde naam, hetzelfde adres, dezelfde omschrijving — dan is er één bedrijf in plaats van drie half overlappende versies.
Geen van deze vier zegt iets over wie het werk beter doet. Ze zeggen iets over hoeveel eenduidige tekst er over iemand bestaat. Dat is een oncomfortabele constatering, maar wel de eerlijke — en het is precies het deel waar je zelf iets aan kunt doen.
Hoe zit het met „ik sta hoog in Google”?
Goed vindbaar zijn in een zoekmachine en genoemd worden door een AI-assistent zijn twee verschillende dingen. Een zoekmachine kiest pagina's; een taalmodel stelt zinnen samen. Een deel van de assistenten zoekt tijdens het antwoorden wél op het web, en daar helpt een pagina die goed vindbaar is. Maar een antwoord uit het geheugen van het model doet dat niet: dat put uit wat er tijdens de training in de tekst zat. Daarom meten wij die twee banen apart waar de API dat toestaat. Waarom ze uit elkaar kunnen lopen — en waarom vijf aanbieders vijf antwoorden geven — staat in „Geeft elke AI hetzelfde antwoord?”.
Wat weet je wél als je het meet, en wat niet?
| Vraag | Wat een meting laat zien | Wat een meting niet laat zien |
|---|---|---|
| Word jij genoemd? | In hoeveel van de 125 antwoorden je voorkomt, uitgesplitst per klantvraag en per aanbieder | Waaróm het model juist jouw naam koos — dat zegt een model niet |
| Wie wordt er wél genoemd? | Welke namen terugkomen en hoe vaak, met de letterlijke zin erbij | Of die bedrijven meer klanten of meer werk hebben; dat wordt niet gemeten |
| Met welk argument? | De zin waarin je genoemd wordt, met een bewijs-ID om hem terug te zoeken | Uit welke bron dat argument komt; die staat niet in het antwoord |
| Verandert het? | De spreiding over vijf herhalingen per vraag, per aanbieder | Wat er volgende maand gebeurt — elke meting blijft een momentopname |
Het verschil tussen die twee kolommen is het hele punt. Je kunt eindeloos speculeren waarom een concurrent wél genoemd wordt; je kunt ook tellen hoe vaak dat gebeurt, bij welke vraag, bij welke aanbieder en met welke woorden. Het tweede is saaier en veel bruikbaarder.
Hoe die 125 antwoorden tot stand komen, welke vijf aanbieders het zijn, en hoe je elk cijfer in het rapport kunt terugzoeken, staat op onze meetmethode.