
Waarom zijn vijf aanbieders vijf verschillende antwoorden?
Wij meten via de officiële API's van vijf AI-aanbieders: ChatGPT (OpenAI), Claude (Anthropic), Gemini (Google), Perplexity, Grok (xAI). Dat zijn vijf verschillende modellen, elk getraind op een eigen mix van teksten, elk met een eigen afstelling en een eigen manier om het web te raadplegen. Dezelfde klantvraag levert daardoor vijf verschillende antwoorden op, met deels andere namen en deels andere argumenten. Assistenten die wij niet meten, laten we buiten het rapport; wat niet gemeten is, presenteren wij niet als resultaat.
Er is nog een verschil dat je niet ziet: elk model heeft een eigen kennisgrens. Anthropic definieert in zijn modeloverzicht de „reliable knowledge cutoff” als „the date through which the model's knowledge is most extensive and reliable”. Twee aanbieders kunnen dus letterlijk een andere versie van jouw markt in hun geheugen hebben, simpelweg omdat hun training op een andere datum stopte.
Waarom vraag je hetzelfde vijf keer achter elkaar?
Omdat één antwoord niet herhaalbaar is. In de API-documentatie van Anthropic staat het letterlijk: de resultaten zijn „even with temperature of 0.0 … not fully deterministic”. Stel dezelfde vraag twee keer achter elkaar en je kunt twee verschillende namenlijstjes krijgen, zonder dat er iets veranderd is aan jouw bedrijf of aan de vraag. Wie op basis van één antwoord concludeert dat hij „er niet in staat”, meet in feite het toeval.
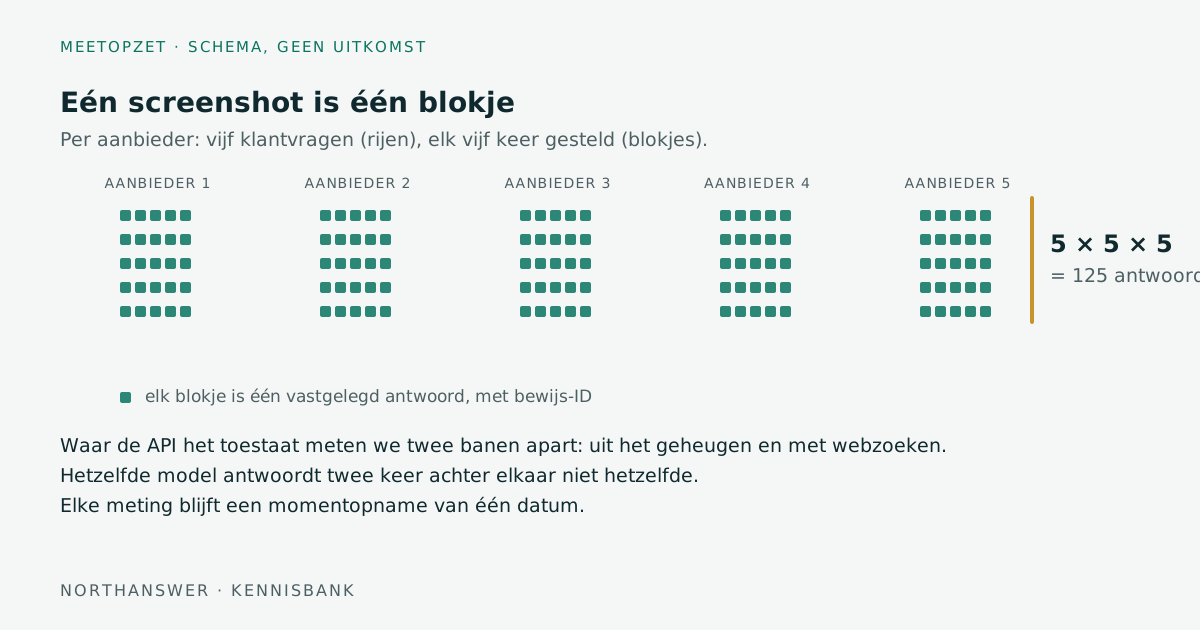
Vijf herhalingen per vraag zijn geen statistische zekerheid — dat pretenderen we niet. Ze zijn genoeg om het verschil te zien tussen „nooit genoemd” en „soms genoemd”, en om een spreiding te laten zien in plaats van een enkel toevalstreffertje. Daarom rapporteren wij per klantvraag hoe vaak je in vijf pogingen voorkwam, per aanbieder, en niet één samengevat cijfer.
Wat is het verschil tussen geheugen en webzoeken?
Een assistent kan op twee manieren antwoorden. Uit het geheugen van het model: dan put hij uit de tekst waarop hij getraind is, en zie je wat er in de afgelopen jaren over jou geschreven is. Of met webzoeken: dan haalt hij tijdens het antwoorden pagina's op en gebruikt die. Dat zijn twee verschillende vragen met twee verschillende antwoorden, en ze samentellen verbergt precies wat je wilt weten. Een bedrijf dat alleen via webzoeken genoemd wordt, staat er anders voor dan een bedrijf dat ook uit het geheugen komt — het eerste hangt van de zoekopdracht van dat moment af, het tweede zit in het model zelf.
Wij meten die twee banen daarom apart, waar de API van een aanbieder dat toestaat. Waar dat niet kan, staat in het rapport welke baan gemeten is en welke niet gemeten is. Wat je aan die twee uitkomsten kunt doen, staat in „AI noemt je niet — wat kun je doen?”.
Waarom wijkt jouw eigen ChatGPT-app af van een API-meting?
Wat jij in je eigen app ziet, is jouw antwoord — niet hét antwoord. Consumenten-apps houden rekening met je gespreksgeschiedenis, je locatie, je taal, je instellingen en soms met een andere modelversie dan de API. Wie zijn eigen bedrijf intypt en zichzelf terugziet, heeft daarmee niets bewezen: de assistent weet dat je jezelf net gezocht hebt. Dat is geen fout van de app; het is precies waar hij voor gemaakt is.
Een API-meting doet dat bewust niet. Geen geschiedenis, geen profiel, een vastgelegde vraag, een vastgelegd model, een vastgelegde datum — voor iedereen gelijk en door ons herhaalbaar. Daarom is een API-meting geen betere weergave van jouw ervaring, maar wel de enige die je met een maand later kunt vergelijken.
Wat bewijst één screenshot, en wat bewijzen 125 antwoorden?
| Wat varieert | Hoeveel | Waarom het apart geteld wordt |
|---|---|---|
| Aanbieder | 5: ChatGPT (OpenAI), Claude (Anthropic), Gemini (Google), Perplexity, Grok (xAI) | Ander model, andere bronnenmix, andere kennisgrens |
| Klantvraag | 5, vóór de meting vastgelegd | Eén vraag is te smal; vijf vragen dekken hoe klanten het echt vragen |
| Herhaling per vraag | 5 | Hetzelfde model antwoordt twee keer achter elkaar niet hetzelfde |
| Baan | 2, waar de API het toestaat: uit het geheugen en met webzoeken | Twee verschillende vragen; samengeteld verbergen ze elkaar |
| Totaal | 5 × 5 × 5 = 125 geplande antwoorden | Genoeg om een patroon te zien, niet genoeg om de toekomst te voorspellen |
Een screenshot is één blokje uit die tabel: bij één van de vijf aanbieders, bij één vraag, in één poging, in één baan, op één moment. Het kan kloppen en toch niets betekenen. Honderdvijfentwintig antwoorden zijn geen bewijs van wat er morgen gebeurt, maar ze laten wel zien of je nooit, soms of vaak genoemd wordt, bij welke vraag dat kantelt en bij welke aanbieder. Elk antwoord krijgt een bewijs-ID, zodat je de letterlijke zin kunt terugzoeken in plaats van ons op ons woord te geloven.
De volledige opzet, inclusief hoe de vragen worden vastgelegd en hoe de bewijs-ID's werken, staat op onze meetmethode.