
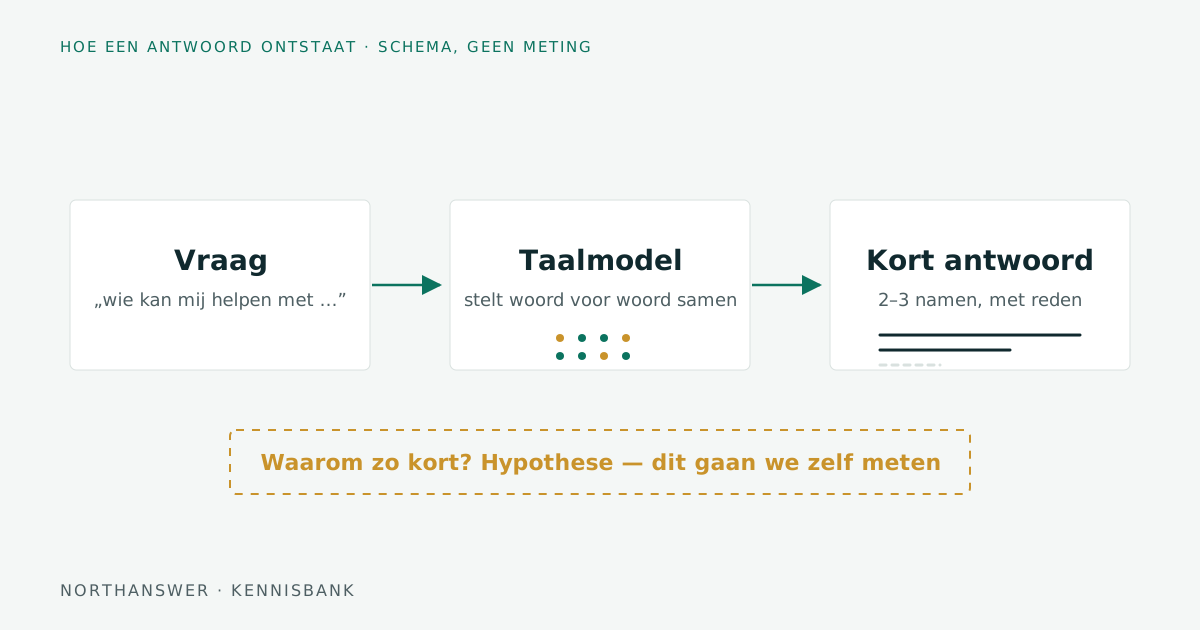
Is het eigenlijk waar dat AI-assistenten maar een paar bedrijven noemen?
Eerlijk antwoord: dat is onze werkhypothese, geen vastgesteld feit. Wie zelf een paar keer „wie kan mij helpen met…” typt, ziet meestal een kort lijstje met twee tot vijf namen en een reden per naam. Maar „meestal” is een indruk uit eigen proberen, geen meting over honderden vragen en meerdere assistenten. Een stellige zin als „AI noemt nooit meer dan twee bedrijven” zou meer beweren dan we kunnen onderbouwen. Daarom staat dit artikel in vraagvorm, en markeren we hieronder bij elke verklaring of het een aanname is, een uitspraak van een aanbieder, of iets wat we zelf gaan meten.
Hoe stelt een taalmodel een antwoord samen?
Een taalmodel zoekt niet op in een lijst van bedrijven en kiest daar de beste uit. Het is getraind op heel veel tekst en stelt een antwoord woord voor woord samen, op basis van wat in die tekst het meest waarschijnlijk volgt. Twee eigenschappen van dat proces zijn door de aanbieders zelf beschreven. Ten eerste heeft de kennis een grens: Anthropic definieert in zijn modeloverzicht de „reliable knowledge cutoff” als „the date through which the model's knowledge is most extensive and reliable”. Wat daarna is verschenen, kent het model alleen als het live op het web zoekt. Ten tweede zit er toeval in: volgens de API-documentatie zijn de resultaten „even with temperature of 0.0 … not fully deterministic”. Beide pagina's zijn technische documentatie zonder publicatiedatum, door ons geopend op 1 september 2026 — geen onderzoek, wel uitspraken van de aanbieder over het eigen product.
Wat dit voor bedrijfsnamen betekent, is een redenering, geen meting: een naam die vaak en consistent voorkomt in de tekst waarop het model is getraind (en in wat het eventueel live vindt), heeft meer kans om in een antwoord op te duiken dan een naam die zelden of wisselend wordt beschreven. Hoe sterk dat effect is, weten we niet.
Waarom zou een antwoord kort zijn?
Hiervoor hebben we geen sterke primaire bron gevonden. We noemen daarom drie mogelijke verklaringen, uitdrukkelijk als hypothesen:
- Hypothese 1 — de vorm van het gesprek. Een chatantwoord is geen zoekresultatenpagina met tien blauwe links; een assistent geeft een leesbaar antwoord, en een leesbaar antwoord bevat zelden tien namen.
- Hypothese 2 — de vraag zelf. „Wie kan mij helpen met…” vraagt om een aanbeveling, niet om een overzicht. Een vraag als „geef een lijst van twintig aanbieders” levert waarschijnlijk een langer antwoord op. Of dat zo is, is te testen.
- Hypothese 3 — de afstelling van het model. Aanbieders stemmen hun modellen af op bruikbare, beknopte antwoorden. Dat staat in algemene termen in hun documentatie, maar niet als „noem maximaal drie bedrijven”.
Welke bedrijven komen dan wél in zo'n antwoord terecht?
Ook hier: aannames, geen gemeten feiten. Het ligt voor de hand dat bedrijven die op veel plekken duidelijk en eenduidig beschreven staan — wat ze doen, voor wie, waar — vaker terugkomen dan bedrijven waarover weinig of tegenstrijdige tekst bestaat. Het ligt ook voor de hand dat de argumenten die de AI noemt („gespecialiseerd in…”, „goed beoordeeld voor…”) ergens vandaan komen. Maar of dat in jouw markt zo werkt, en welke bronnen dan doorslaggevend zijn, kun je alleen zien door het te meten: dezelfde vraag herhaald stellen en per antwoord vastleggen wie genoemd wordt en met welke reden. Dezelfde vraag vanuit het perspectief van je concurrent staat in „Waarom noemt ChatGPT mijn concurrent wel?”.
Wat is hier aanname en wat is gemeten feit?
| Bewering | Status | Hoe we het zouden kunnen vaststellen |
|---|---|---|
| AI-assistenten noemen bij een klantvraag meestal twee tot vijf bedrijven | Aanname (eigen indruk) | Per markt tellen over 125 antwoorden per vragenset; rapporteren als aantal, niet als „altijd” |
| Antwoorden verschillen per keer, ook bij dezelfde vraag | Uitspraak van de aanbieder (Anthropic-documentatie) + eigen ervaring | Vijf herhalingen per vraag vastleggen en de spreiding tonen |
| Een model kent alleen wat vóór de kennisgrens is gepubliceerd, tenzij het live zoekt | Uitspraak van de aanbieder (Anthropic-documentatie) | Per meting noteren wij of webzoeken aan stond; wij meten beide banen apart waar de API dat toestaat |
| Vaak en eenduidig beschreven bedrijven worden vaker genoemd | Aanname (redenering) | Genoemde bedrijven vergelijken met hoe ze online beschreven staan — nog niet gedaan |
| Korte antwoorden komen door de gespreksvorm, de vraag of de afstelling | Drie hypothesen, geen bron | Vraagformulering variëren en antwoordlengte meten |
Wat kun je hier nu al mee?
Twee dingen. Ten eerste: probeer het zelf, met een paar echte klantvragen, en herhaal ze — hoe je dat doet en wat je eruit mag concluderen staat in „Zo controleer je het zelf”. Ten tweede: zorg dat wat er over je bedrijf te lezen valt klopt en eenduidig is — dat is nuttig ongeacht hoe AI-antwoorden precies tot stand komen, en het is het enige wat je zelf in de hand hebt. Beloven dat een AI je daarna noemt, kan niemand; wat we wél kunnen, is meten waar je staat.